Разворачиваем ваши модели на нашей инфраструктуре: сервера на ускорителях Ascend 910B в российском ЦОДе, готовые среды, OpenAI-совместимый API, квантизация под железо. Для CTO: ниже — что реально работает на платформе, как подключаться и что фиксируется в SLA.
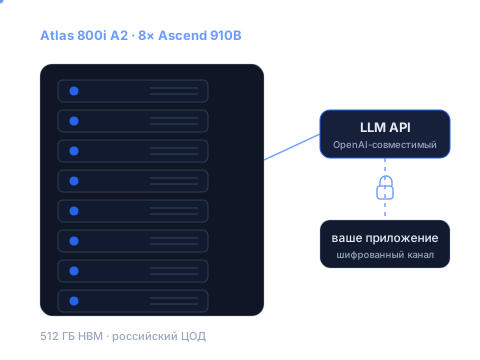
От одной ускорительной карты до полной системы (8× Ascend 910B, 64 ГБ HBM на карту). Конфигурация подбирается под размер вашей модели и нагрузку.
Привезли модель — мы развернём: среда выполнения, квантизация под железо, оптимизация скорости ответа. Готовое окружение, а не «голое железо».
Стандартный OpenAI-совместимый API: ваш фронтенд или приложение подключается к модели в пару строк кода.
Сервер в российском ЦОДе, шифрованный канал до вашего приложения, NDA. Персональные данные и базы знаний обрабатываются в РФ — фактические меры 152-ФЗ.
Инференс, RAG, аудио, анализ документов — настроим под нагрузку: от пилота до промышленного трафика.
Мониторинг, обновления моделей и окружения, масштабирование по мере роста нагрузки. Доступность и время восстановления — в SLA.
Ваш код подключается без смены библиотеки. Пример:
Конкретный endpoint и ключи — в инструкции подключения после подключения. Формат ответов совместим с API OpenAI.
Три варианта — от пилота до промышленного трафика. Цены и условия — на странице «Цены».
| Конфигурация | Что запускать | Типичные задачи | Цена |
|---|---|---|---|
| 1× Ascend 910B (64 ГБ HBM) | Модели 7–14B (квантизация) | Инференс, RAG, ассистенты, аудио | по расчёту |
| 4× Ascend 910B (256 ГБ HBM) | Модели 14–32B, параллельные потоки | Крупные LLM, сложные агенты | по расчёту |
| 8× Ascend 910B (512 ГБ HBM, полная система) | Модели 32B+, несколько сервисов | Промышленный трафик, высокие p95-нагрузки | по расчёту |
Точные цены — по конфигурации под вашу модель и нагрузку, в течение 24 часов. Тест запуска модели на нашей инфраструктуре — 24 часа бесплатно.
Пришлите название модели и пример нагрузки (запросов в час, длина контекста) — ответим с конфигурацией, скоростью и ценой. Ответим в течение 24 часов.
